Per anni la digitalizzazione del procurement ha prodotto una quantità crescente di dati. Spesa, contratti, performance dei fornitori, ordini, fatture, prezzi, benchmark, informazioni sul rischio: oggi una funzione acquisti può accedere a una mole di informazioni che vent’anni fa sarebbe stata difficile persino immaginare.
Ma avere più dati non significa necessariamente saperli utilizzare meglio. Secondo McKinsey, le funzioni Procurement utilizzano oggi meno del 20% dei dati disponibili per supportare il processo decisionale. Un limite che l’arrivo dell’intelligenza artificiale sta rendendo ancora più evidente.
L’AI non ha bisogno solo di dati. Ha bisogno di contesto
La prima fase della digitalizzazione degli acquisti ha avuto soprattutto un obiettivo: rendere le informazioni disponibili e visibili.
Dashboard, piattaforme di spend analytics e strumenti di business intelligence hanno consentito ai buyer di osservare i dati, analizzarli e utilizzarli per prendere decisioni.
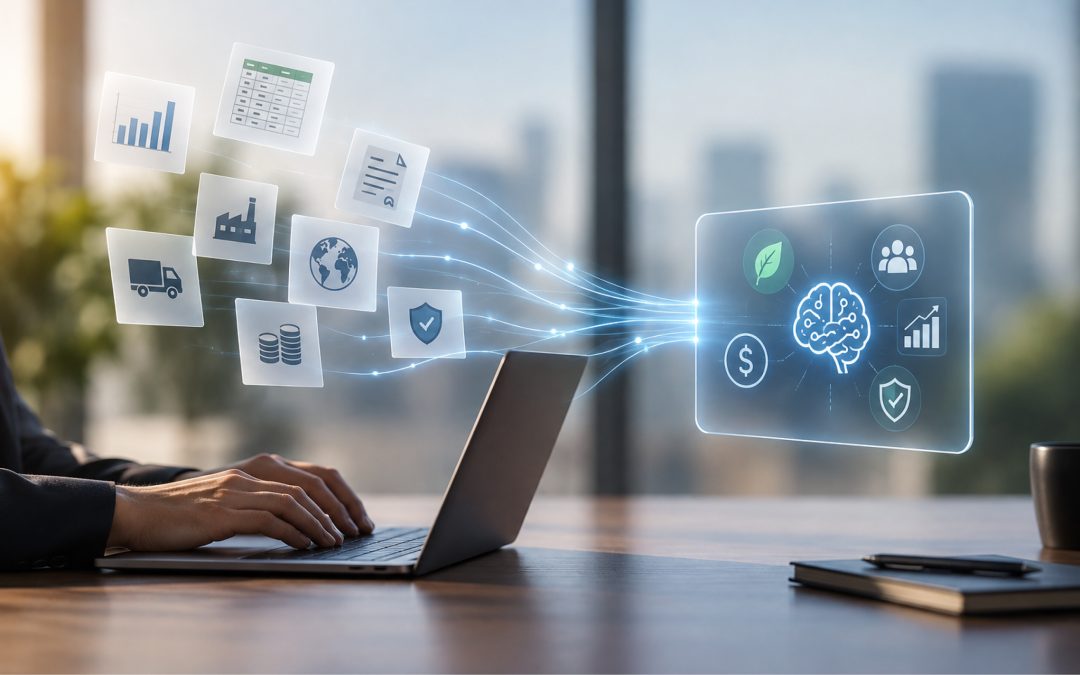
Con l’intelligenza artificiale, però, la prospettiva cambia. Immaginiamo un agente AI incaricato di valutare un fornitore. Per formulare una valutazione realmente utile potrebbe aver bisogno di conoscere contemporaneamente la spesa storica dell’azienda con quel supplier, i contratti in essere, le performance operative, le condizioni commerciali negoziate, la situazione finanziaria e gli eventuali rischi geografici.
Lo stesso vale per una negoziazione. Un agente incaricato di prepararla potrebbe dover mettere in relazione prezzi storici, volumi acquistati, commodity index, benchmark esterni, clausole contrattuali e andamento del mercato.
Il punto è proprio questo: più l’AI passa dalla semplice generazione di contenuti al supporto delle decisioni – e progressivamente all’esecuzione di alcune attività – maggiore diventa la quantità di contesto di cui ha bisogno per funzionare bene.
Ed è qui che molte organizzazioni incontrano il primo vero ostacolo.
Quando i dati esistono, ma non dialogano tra loro
Nella maggior parte delle aziende il problema non è necessariamente la mancanza di informazioni. È il modo in cui queste informazioni sono distribuite.
Spend data, supplier master, contract repository, ERP e sistemi di risk management possono contenere pezzi diversi della stessa storia, utilizzare classificazioni differenti o persino identificare in modo diverso lo stesso fornitore e la stessa categoria merceologica.
Il risultato è un paradosso: i dati ci sono, ma non sono necessariamente pronti per essere utilizzati dall’AI.
Il tema emerge anche dal ProcureCon CPO Study 2026. Il 65% delle organizzazioni coinvolte dichiara di avere iniziative AI in fase pilota, ma soltanto l’11% si considera pronto a utilizzare AI e machine learning su scala nelle operations Procurement.
Tra gli ostacoli indicati compaiono proprio alcuni dei problemi meno visibili della trasformazione digitale: sistemi frammentati, qualità dei dati e governance. E questo suggerisce che la prossima fase della trasformazione del procurement potrebbe essere molto diversa dalla precedente.
Dalla spend visibility alla data architecture
Negli ultimi anni molte funzioni acquisti hanno investito nella spend visibility. L’obiettivo era costruire una rappresentazione sufficientemente affidabile di ciò che l’azienda acquistava: quanto spendeva, con quali fornitori, per quali categorie e in quali aree geografiche.
È stato un passaggio fondamentale. Ma l’agentic AI richiede qualcosa in più. McKinsey parla della necessità di costruire una “data spine” comune, capace di collegare informazioni relative a spesa, fornitori, contratti e benchmark di mercato.
Questo non significa necessariamente concentrare tutti i dati in un unico grande sistema. Significa piuttosto fare in modo che informazioni provenienti da fonti differenti possano essere riconosciute, collegate e interpretate attraverso una struttura coerente.
La differenza è sostanziale. La spend visibility serve soprattutto a permettere alle persone di vedere e comprendere meglio ciò che sta accadendo. Una data architecture pensata per l’AI deve consentire anche alle macchine di comprendere le relazioni tra quelle informazioni.
Il vantaggio competitivo potrebbe essere il contesto
È possibile allora che, nei prossimi anni, la distanza tra le organizzazioni non dipenda soltanto da chi adotterà per primo l’intelligenza artificiale. Potrebbe dipendere soprattutto da chi avrà costruito il contesto migliore nel quale farla lavorare.
Due aziende potranno utilizzare modelli di AI comparabili e ottenere risultati molto diversi. Una potrebbe disporre di dati affidabili e collegati su fornitori, contratti, prezzi, performance e rischi. L’altra potrebbe continuare a lavorare con informazioni frammentate tra sistemi diversi, tassonomie incoerenti e livelli di qualità non omogenei.
Il modello potrebbe essere lo stesso. La qualità delle decisioni, no. È una prospettiva forse meno spettacolare rispetto alla promessa degli agenti autonomi capaci di negoziare, analizzare mercati o gestire processi source-to-pay. Ma potrebbe essere molto più importante.
Perché, prima ancora di chiedersi quale AI utilizzare, il procurement dovrebbe probabilmente iniziare da una domanda più semplice: quanto bene conosce – e collega – i propri dati?